Erasure Coding:不用存三份完整副本,也能扛硬盘故障吗?
TL;DR
纠删码将数据与校验信息分片存储,在符合恢复条件时重建丢失数据,以存储效率换取额外计算和恢复成本。本文用 Ceph 说明关键取舍。
纠删码将数据与校验信息分片存储,在符合恢复条件时重建丢失数据,以存储效率换取额外计算和恢复成本。本文用 Ceph 说明关键取舍。
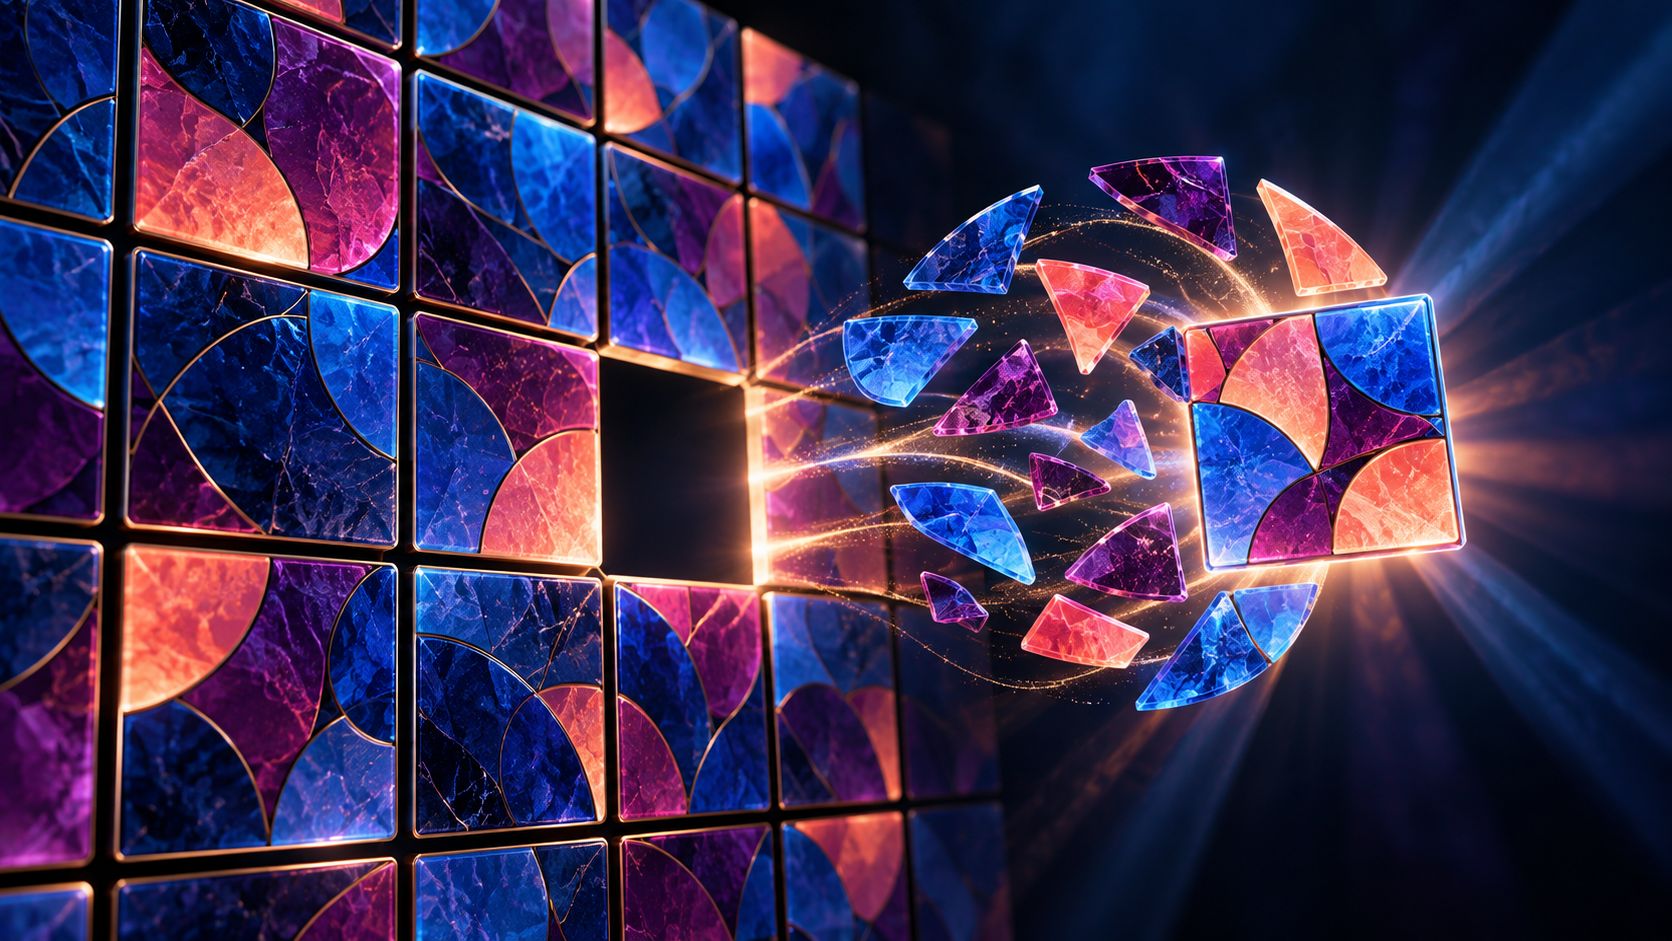
保存三份完整副本很直观:一块硬盘坏了,还能从另外两份读回。但三副本也意味着存储原始数据要付出约三份容量成本。Erasure Coding(纠删码)使用另一种办法:把数据拆成若干数据分片,再计算额外的校验分片;丢失一定数量的分片时,可以从剩余分片重建原始数据。
在常见的 K+M 配置中,K 代表数据分片数量,M 代表额外编码分片数量。系统把一段对象编码为 K 个数据分片和 M 个校验分片,再把它们放到不同磁盘或故障域。只要可用分片数量和组合满足编码方案的恢复条件,数据就能重建。直觉上像把一道题拆成几份信息,再多保存几条冗余关系,缺几块仍可解出答案。
和完整副本相比,纠删码通常能用较少额外容量提供一定故障容忍度,但不是“无成本省空间”。写入时需要计算编码,读取缺失数据可能需要从多个分片收集信息;恢复故障磁盘上的数据会带来网络、CPU 和磁盘 I/O 负载。小对象、频繁覆盖或延迟敏感读写是否适合,取决于实现和工作负载,不能只按容量比例决定。
放置策略同样重要。若数据分片和校验分片都落在同一机架,机架故障可能一次带走太多碎片,使原本可恢复的数据不可恢复。系统因此要把分片分散到不同磁盘、主机甚至机架等故障域,并监测降级状态。配置中的 M 并不是对所有灾难的保证:多个相关故障、维护操作或副本布局错误都可能超出容错范围。
以 Ceph 为例,纠删码池会按配置保存数据与编码分片,并通过恢复过程修复缺失部分。需要支持覆盖写时,往往还有额外机制和性能权衡。评估生产方案时应同时测量空间利用率、编码 CPU、读写时延、重建吞吐和故障期间的服务质量,还要验证故障域分布是否真的符合目标。
纠删码适合愿意用计算与恢复复杂度换取更高存储效率的系统。完整副本仍然简单、快速且易于理解;纠删码则让冗余从“多存几份”变成“存足够的信息”,两者各有适用范围。