HNSW:向量数据库怎样在“小世界图”里快速找相似项?
TL;DR
HNSW 把向量组织为多层可导航图,从稀疏高层逐步下探到局部候选区域,以较少距离计算近似查找邻居。本文讲解图搜索原理,以及召回率、延迟、构建和内存之间的权衡。
HNSW 把向量组织为多层可导航图,从稀疏高层逐步下探到局部候选区域,以较少距离计算近似查找邻居。本文讲解图搜索原理,以及召回率、延迟、构建和内存之间的权衡。
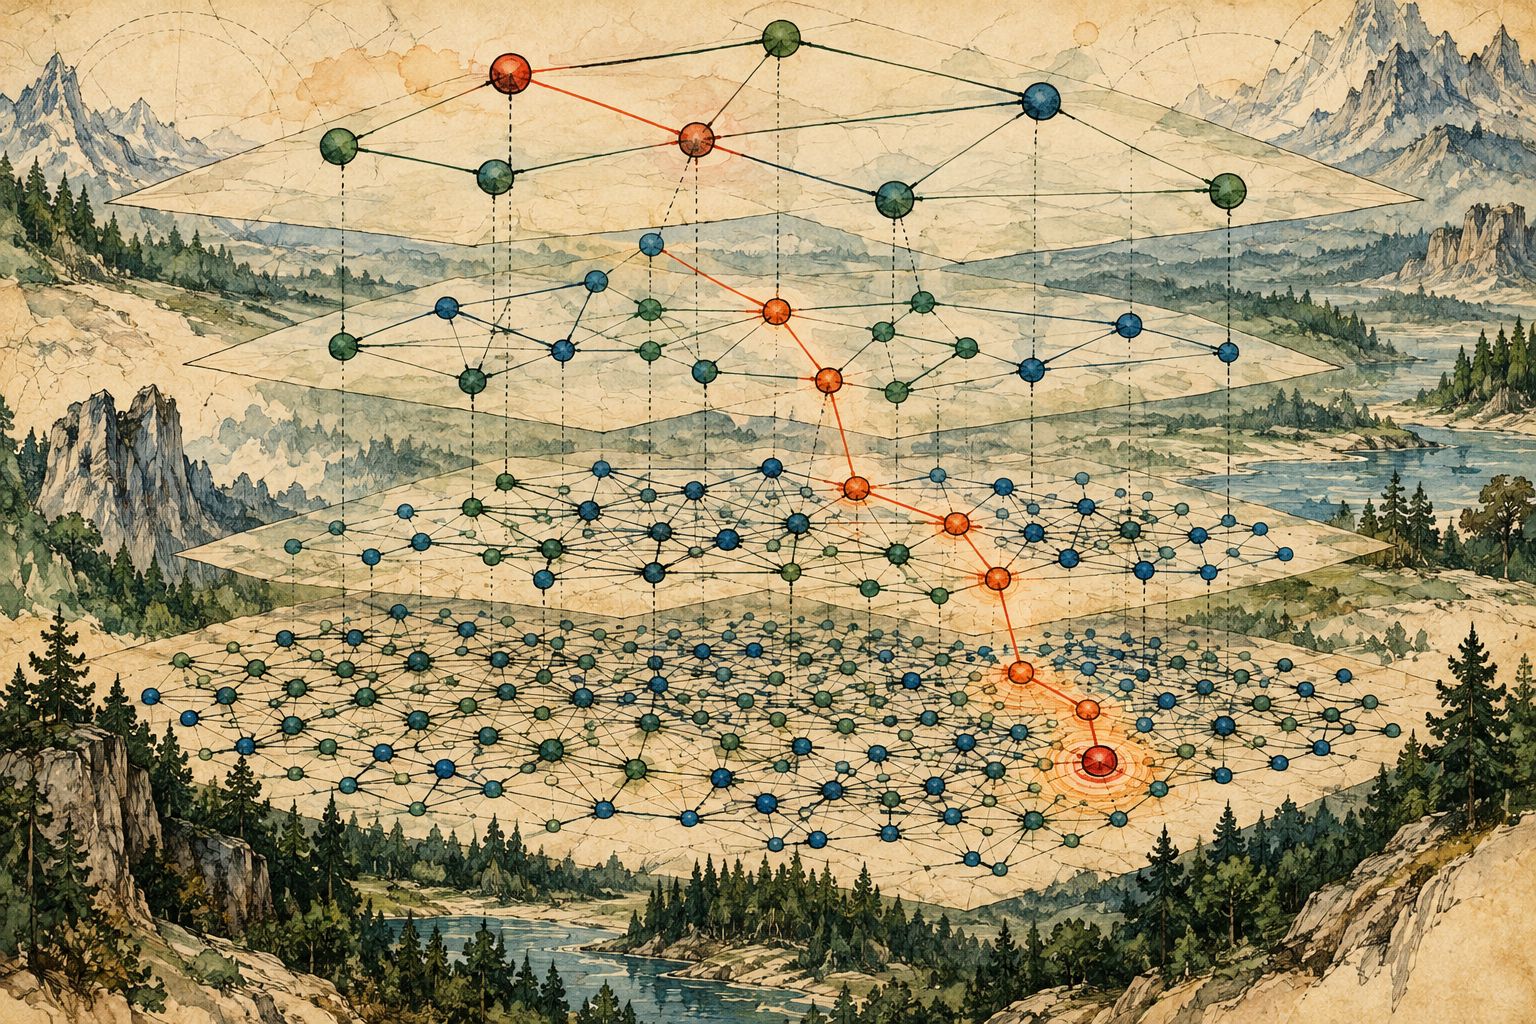
向量检索常见的问题是:给定一个查询向量,怎样从数百万条向量中快速找出最相似的若干条?逐个计算距离当然准确,但数据一大就很慢。HNSW(Hierarchical Navigable Small World)是一种近似最近邻索引,把向量组织成多层图,通过图上的导航快速接近目标区域。
在每一层里,节点代表数据向量,边连接一部分邻居。高层节点较稀疏,像地图上的高速公路入口;底层覆盖更多数据,连接也更细。查询时,算法从高层某个入口开始,沿着能让查询距离变小的边逐步移动;到达当前层的局部区域后,再下降到下一层继续搜索,最后在底层候选集合附近做更细致的比较。
这种“小世界”结构的直觉,是很多节点之间虽然并不直接相连,却能通过少数几跳到达;层级设计进一步提供长距离跳转与局部精查的组合。与线性扫描相比,HNSW 往往能用较少的距离计算找到相当接近真实最近邻的候选,适合语义搜索、图像相似检索和推荐系统等高维向量任务。
“近似”意味着它不承诺每次都找到数学上真正最近的邻居。索引构建时的连接策略、查询时探索候选数量等参数,会在召回率、速度和内存占用之间形成取舍。搜索更广通常能提高召回,却增加延迟;索引图连得更密,查询可能更容易导航,但会占更多空间,构建也更费时。
HNSW 的索引通常需要在内存中保存向量或其访问结构与邻居链接,所以大规模部署要认真估算内存。数据持续更新时,也要考虑插入、删除、重建和过滤条件对索引质量的影响。它是向量数据库常见的索引方法之一,但并非所有维度、数据分布和延迟目标下都最合适。
可以把它想成在陌生城市找一家店:先走高速路到大致街区,再换小路靠近门牌;不必逐一访问全城每栋建筑,但有时会错过真正最近的那一家。HNSW 的核心调参问题也很类似:愿意多走多少步,来换取更有把握的结果?因此评估时应以实际数据测量召回率、延迟、构建成本和内存,而不是只看“用了 HNSW”这个标签。
来源:Malkov 与 Yashunin:Efficient and robust approximate nearest neighbor search using HNSW