ORCA:大模型服务怎样在每生成一个 token 后重排队伍?
TL;DR
ORCA 提出 iteration-level scheduling:大模型每轮生成后都重新安排批次,让刚完成的请求退出、新请求及时进入。本文用公交发车与流水线的比喻解释连续批处理的效率,也讨论调度器如何平衡吞吐与等待时间。
ORCA 提出 iteration-level scheduling:大模型每轮生成后都重新安排批次,让刚完成的请求退出、新请求及时进入。本文用公交发车与流水线的比喻解释连续批处理的效率,也讨论调度器如何平衡吞吐与等待时间。
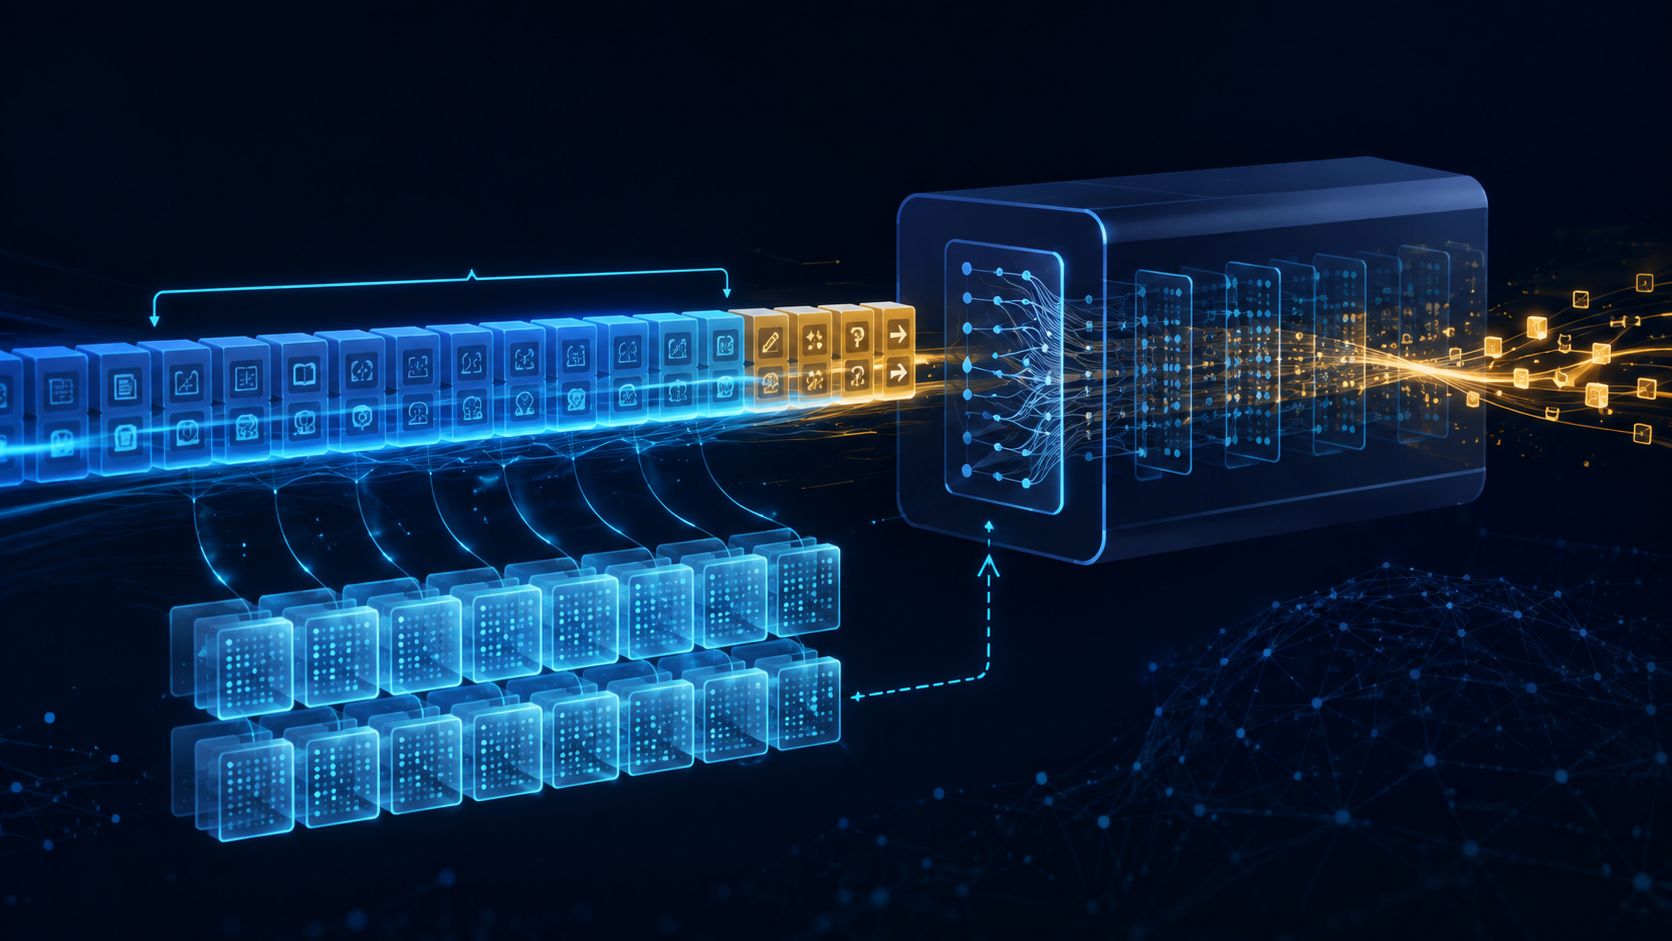
大模型服务常常同时处理许多用户请求。传统批处理可能把一组请求一起送入 GPU,但生成长度不同:有的回答很快结束,有的还要继续很久。若必须等整批最慢的请求完成才能换入新请求,GPU 就可能出现空档,排队的用户也要等。ORCA 提出的 iteration-level scheduling(迭代级调度)改变了重新组批的时机。
每轮生成后重新看队伍
自回归模型一次迭代通常为每个活跃请求生成一个或一小段 token。ORCA 的调度思路是在每次模型迭代之后重新评估批次:已经结束的请求可以退出,新请求有机会加入,持续生成的请求继续运行。批次不再必须从头到尾绑定同一组用户。
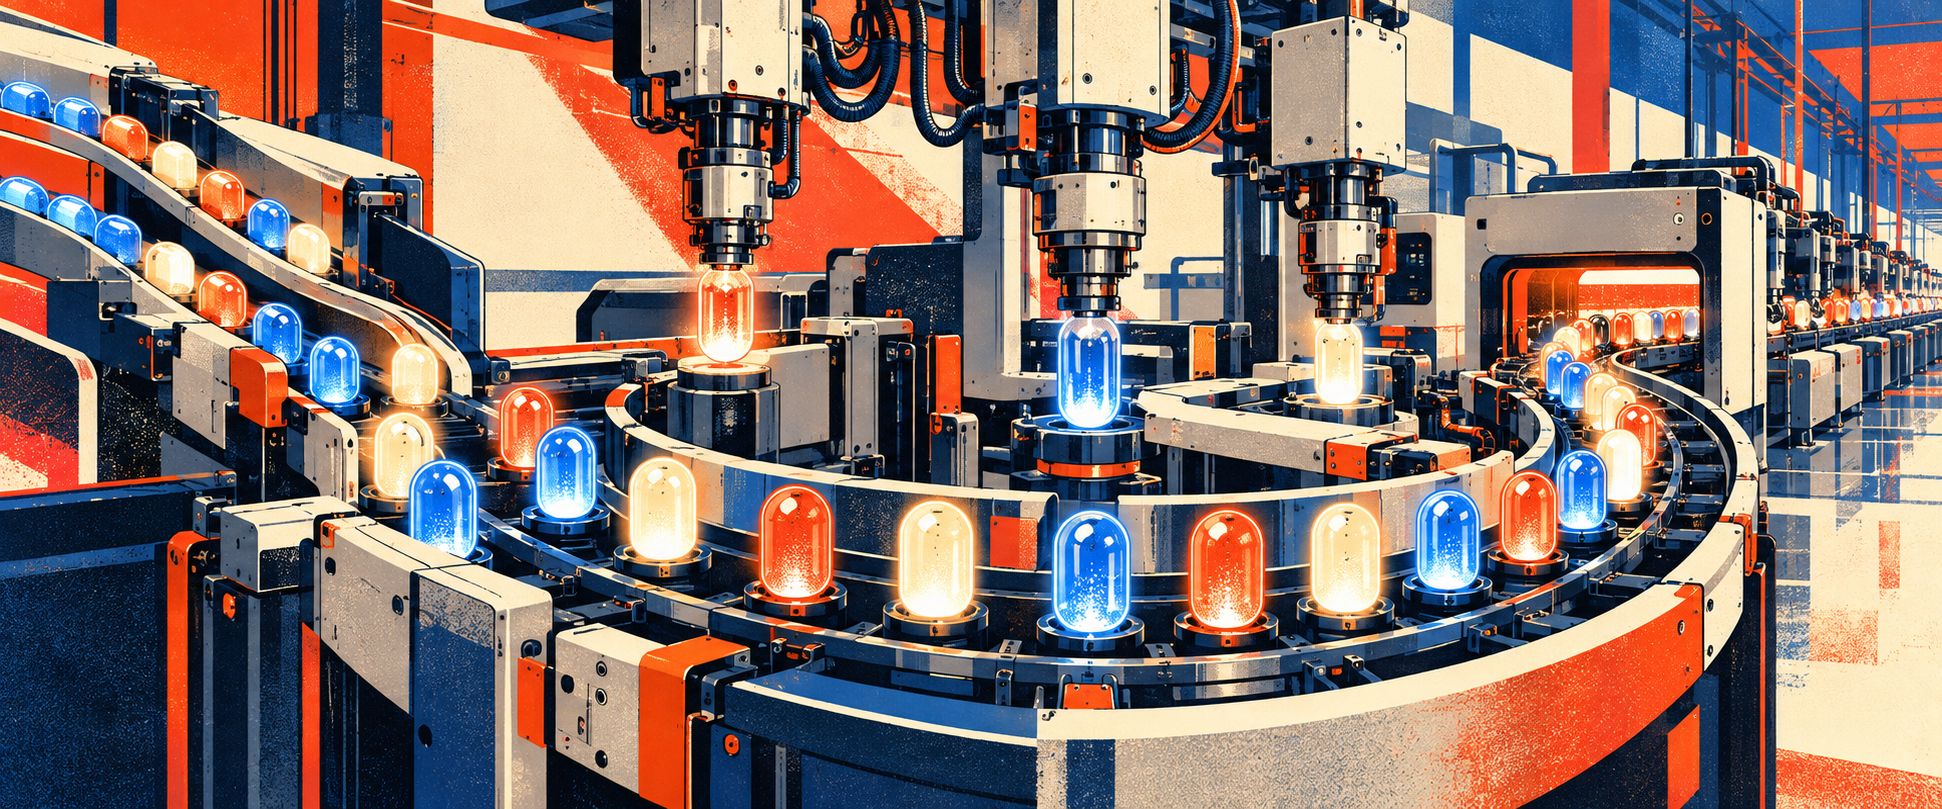
可以把它想成公交车每到一站就重新分配座位:下车的人空出座位,站台上的新乘客可以补上,而长途乘客不需要等整辆车绕完一圈再发车。对在线推理系统而言,这种持续批处理能更灵活地利用 GPU,减少由于输出长度差异造成的空闲。
吞吐提高,还要管理公平与延迟
迭代级调度要求服务端把请求状态、KV Cache 和批次生命周期管理得更细。每轮加入的新请求可能需要预填充输入上下文,老请求则进入逐 token 解码;两类计算的资源需求不同。调度器必须处理显存容量、请求优先级、超时取消和批次切换开销。
连续把新请求塞进 GPU,有机会提升总体吞吐,却不自动保证单个用户更快完成。若系统只追求利用率,长请求或低优先级请求可能等得更久;反之,过度保护单个请求又会降低整体效率。实际服务还需要队列策略、公平性目标和尾延迟控制。
ORCA 的贡献是把“批次”从固定的一组请求,变成每轮都可调整的调度单位。它让大模型在线推理更像持续运行的生产线,而非一车人一起上、一起下。理解这项技术时,要同时关注调度粒度、上下文与解码阶段,以及吞吐和用户等待时间之间的平衡。