φ Accrual Failure Detector:节点没回心跳,系统如何判断它是真的死了?
TL;DR
φ Accrual Failure Detector 根据历史心跳间隔输出连续怀疑度,让系统用概率式信号替代固定超时,更灵活地适应抖动网络。
φ Accrual Failure Detector 根据历史心跳间隔输出连续怀疑度,让系统用概率式信号替代固定超时,更灵活地适应抖动网络。
传统故障检测常用一个固定超时:节点几秒没回心跳,就判定它挂了。这个规则简单,却很难适应不同网络。高峰期的抖动可能让健康节点被误杀,稳定网络里的异常又可能被发现得太慢。φ Accrual Failure Detector 用连续的“怀疑度”替代了僵硬的二元判断。
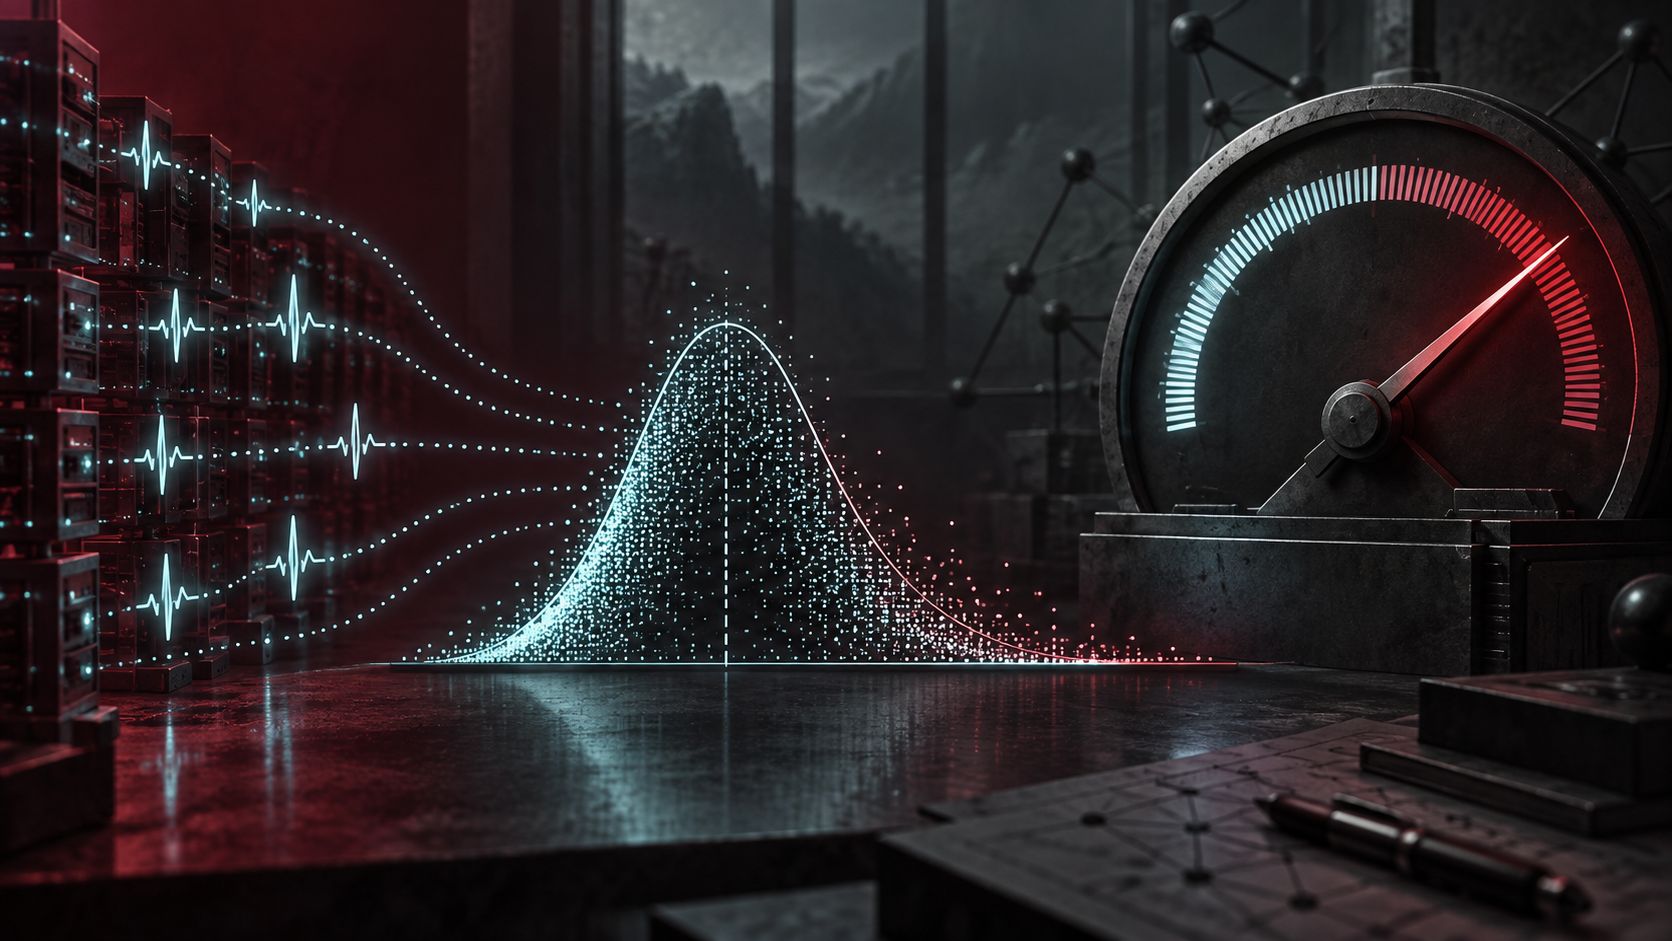
它不会只回答“活着”或“死了”,而是根据过去心跳到达间隔建立一个经验分布。新心跳迟迟未到时,系统计算“出现这么长间隔的概率有多低”,再把这个置信程度转换成 φ 值。心跳只晚了一点,怀疑度低;超过平时范围越多,怀疑度就越高。上层可以根据自己的风险承受力设定阈值。
这像一位熟悉公交车班次的调度员。若公交通常每十分钟到站,晚到两分钟不值得报警;晚到半小时就可疑,但雨天或大型活动可能改变正常分布。调度员不会只看一个固定数字,而会不断根据最近的到站历史调整判断。φ 检测器也会让检测灵敏度随网络和节点行为变化。
连续输出带来灵活性:服务发现可以使用较低阈值快速摘除节点,数据库复制可以使用较高阈值避免误切换,监控系统则可以把怀疑度作为曲线观察。它仍然不能证明节点真的死亡,因为网络分区、进程暂停和链路拥塞都可能造成沉默;最终动作还要结合重试、隔离、租约和状态恢复。
φ Accrual 的价值是把故障检测从一个一次性判断,变成一个持续更新的信念。系统不必把所有环境压缩成同一个超时常数,而可以将观测历史、概率和业务阈值分开,让“多大程度上不放心”成为可配置的工程信号。
阈值的选择仍然是业务决策。低阈值适合希望快速摘除故障实例的无状态服务,高阈值则适合切换代价很高的存储系统;更稳妥的做法是把怀疑度用于触发分级动作,例如先降低流量、再启动探测,最后才隔离和重建。这样可以减少单次网络抖动造成的级联故障。