Seqlock:读者不加锁,为什么还能读到一份一致的数据?
TL;DR
Seqlock 让读者先后读取序列号并在变化时重试,以校验快照是否被写者打断,适合读多写少且字段可安全复制的数据。
Seqlock 让读者先后读取序列号并在变化时重试,以校验快照是否被写者打断,适合读多写少且字段可安全复制的数据。
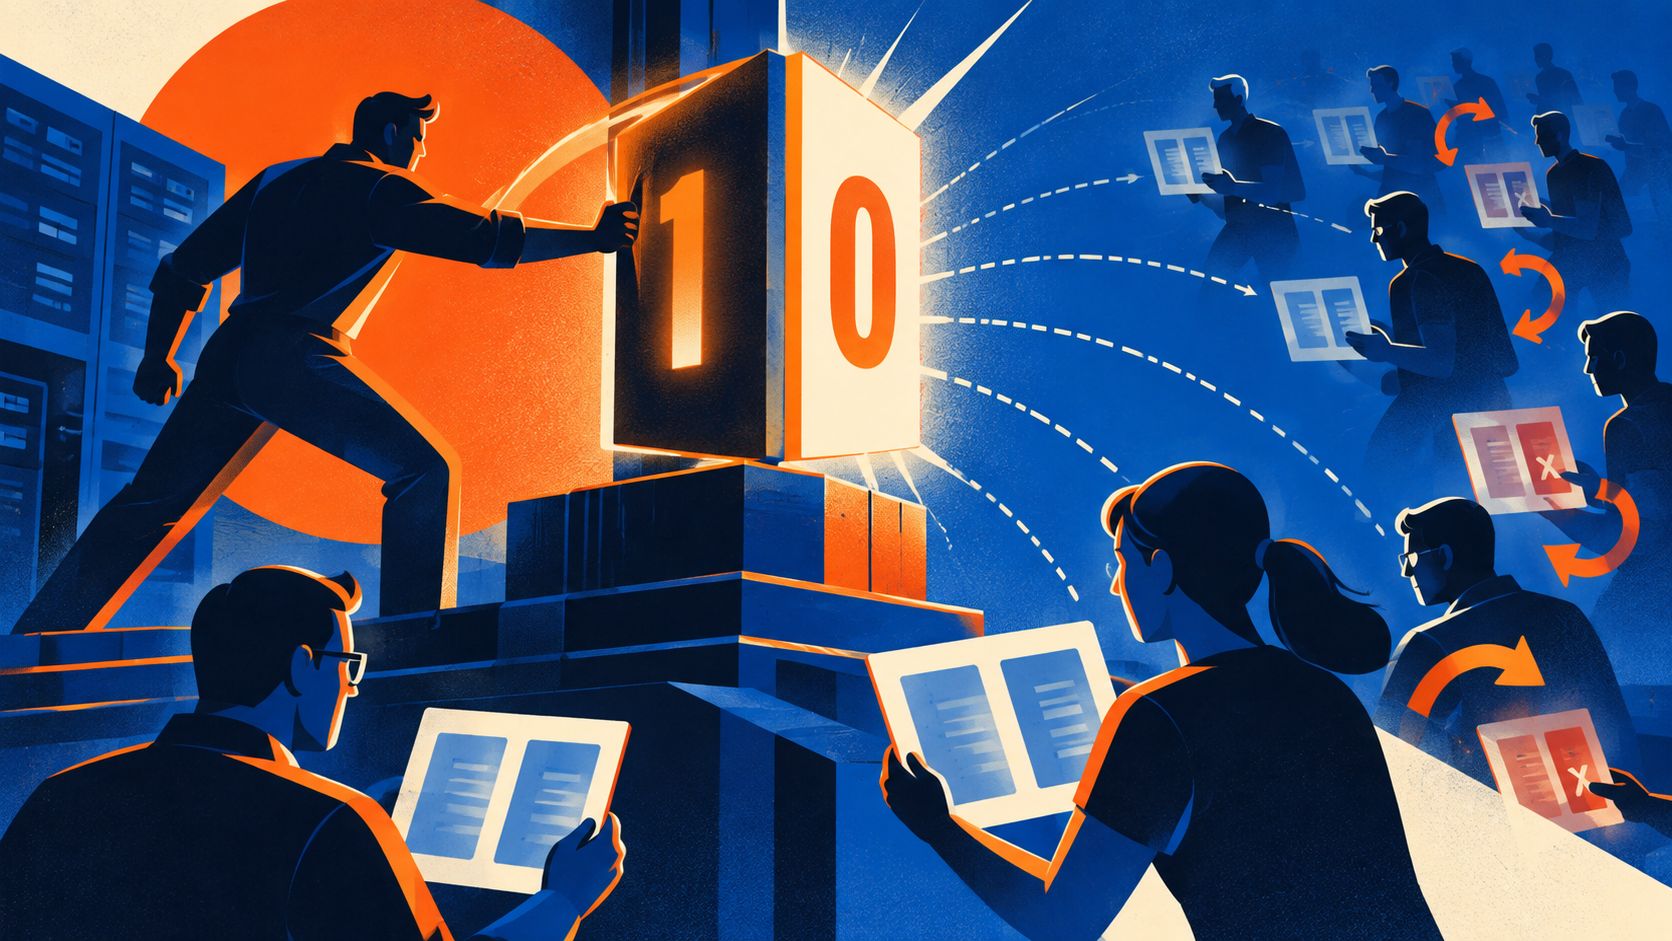
如果一个数据结构读得极多、写得很少,读者为了一次快照去抢锁,可能比真正读取字段还贵。Seqlock(序列锁)提供了另一种思路:读者先读一个序列号,再读取数据,最后再读一次序列号。如果两次序列号不同,或者序列号处在写入中的状态,读者就丢弃结果重试。
它像餐厅门口的换菜牌。没有人写菜单时,牌子显示偶数;厨师开始修改时先把牌子翻成奇数,完成后再翻回新的偶数。顾客可以不排队直接看菜单,但必须在离开前再看一眼牌子。如果牌子在中途变过,说明自己可能读到了半成品,就重新查看。
一个常见的读流程是:读取序列计数器,确认它不是奇数;复制需要的字段;再次读取计数器;只有前后相同才接受快照。写流程则先让计数器进入奇数状态,修改数据,最后发布偶数状态。读者不需要阻塞写者,写者也不必等待所有读者离开,因此在读多写少的结构上很高效。
但 Seqlock 并不适合所有数据。读者可能反复重试,写者很忙时甚至长期得不到稳定快照;数据里如果包含指针,写者修改或释放指向对象后,读者即使最后发现序列号变化,也可能已经访问了失效地址。因此它更适合整数、时间戳、统计值等可以安全复制和校验的字段,不适合随意包裹复杂对象。
理解序列锁的重点,是把“读到一致值”与“读操作从未被打断”区分开。读者允许被写者打断,但不接受不确定的结果。它把阻塞等待换成了校验和重试,也提醒我们:无锁不等于无成本,成本只是从排队转移到了版本检测、内存顺序和最坏情况下的重试次数。
在实践中,读者还要把“复制字段”设计成一个足够短的临界窗口,否则写者越活跃,重试概率越高。工程上常把相关字段打包成小结构,避免跨越多个指针或可变容器。对监控快照、时间状态和硬件计数器来说,少量重试往往比互斥等待更划算;对写入持续爆发的场景,则应重新评估是否需要读写锁或版本化数据结构。
资料来源:Linux Kernel Documentation:Sequence counters and seqlocks