MXFP8:32 个低精度数字怎样共享一个缩放因子?
TL;DR
MXFP8 属于微缩放数值格式:一小组 FP8 数值共享一个独立缩放因子,帮助在低精度下保留可用动态范围。本文拆开“分块缩放”的思路,解释它对训练与推理的意义,以及硬件和数值误差方面的限制。
MXFP8 属于微缩放数值格式:一小组 FP8 数值共享一个独立缩放因子,帮助在低精度下保留可用动态范围。本文拆开“分块缩放”的思路,解释它对训练与推理的意义,以及硬件和数值误差方面的限制。
训练大模型需要大量数值计算,数据越精确通常越占显存、带宽和计算资源。FP8 等低精度格式能减少开销,但数值范围变小后,某些张量容易溢出或精度损失。MXFP8(Microscaling FP8)采用“局部共享缩放因子”的方式,试图让低精度数值既紧凑,又保留更灵活的动态范围。
一组数字共用一个小刻度
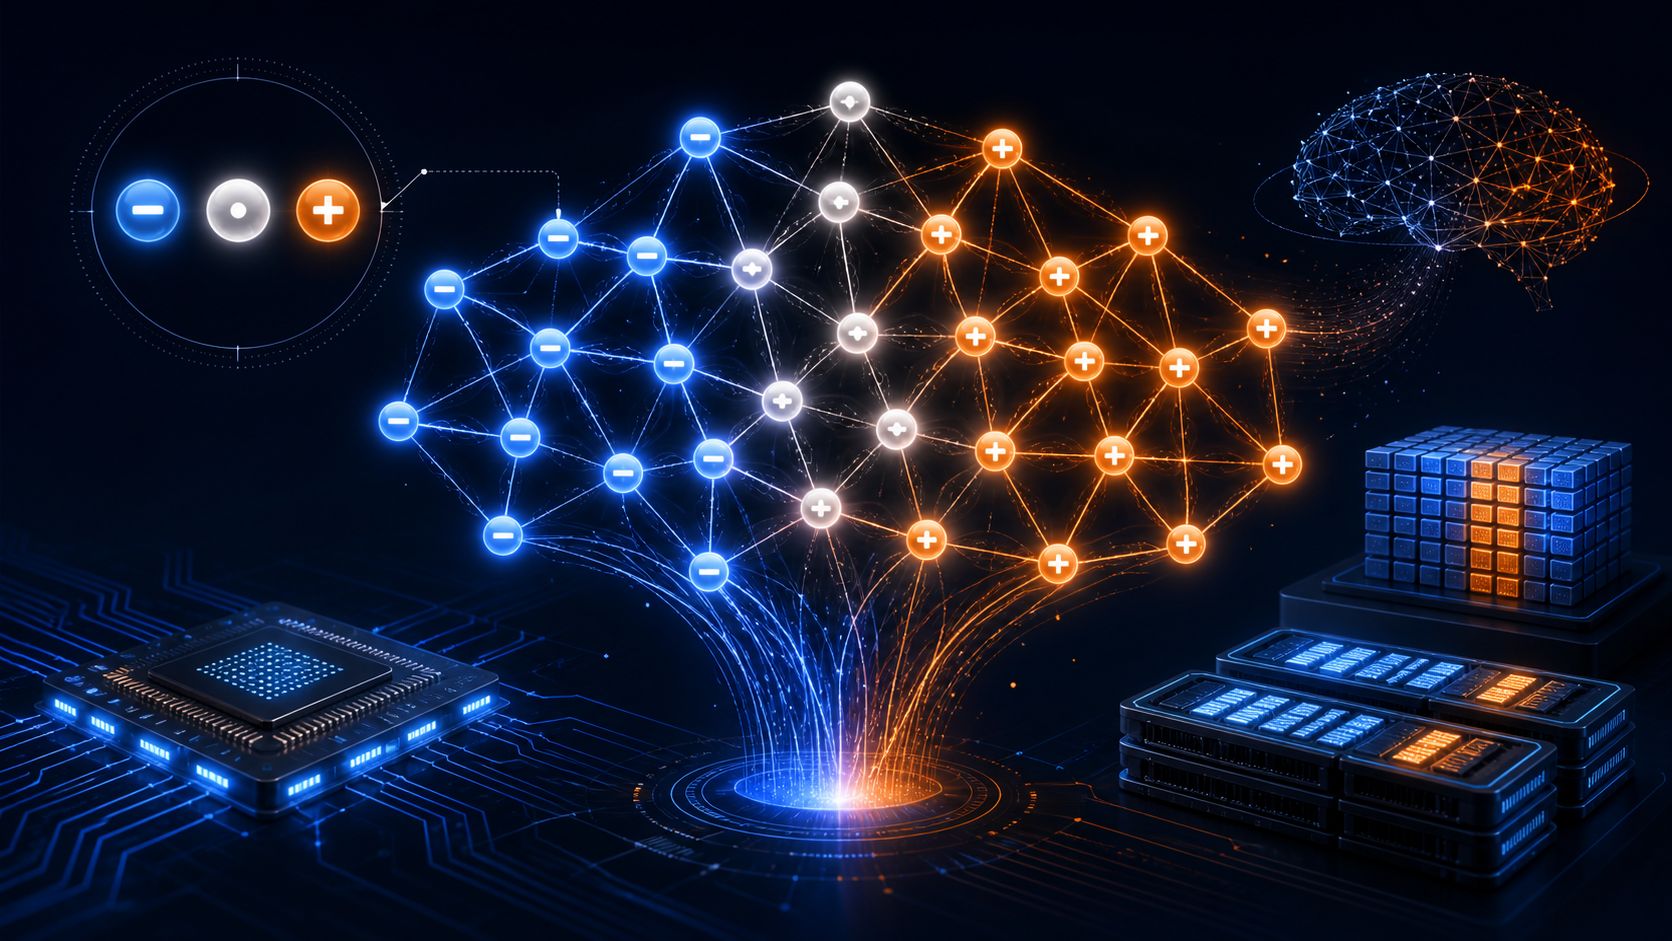
传统缩放可能为整张张量设置一个比例:范围大的数值决定了缩放尺度,范围小的值就可能浪费精度。MXFP8 把数据分成较小的数据块,每块的 FP8 数值共享一个缩放因子。Transformer Engine 文档描述的格式中,缩放因子以 E8M0 表示,并按一组连续数值进行管理;常见分组为 32 个元素。
可以把它想成一张地图上的局部比例尺:整张地图若只用一个尺度,小巷细节和高速公路可能难以同时呈现;每个区域各有比例尺,就能更贴合当地数值范围。硬件在计算时结合块内缩放因子,还原或近似需要的数值关系。
低精度依然需要理解误差
分块缩放不能消灭舍入误差,也不意味着所有模型和所有层都适合 FP8。输入分布、异常值、累计误差、训练稳定性和算子实现都会影响结果。缩放因子本身也需要存储和处理,格式转换可能产生开销。要判断收益,需要基于实际模型测量训练稳定性、吞吐、显存占用和任务质量。
MXFP8 的有效支持还依赖具体软件栈和硬件代际。即使某种 GPU 支持相应计算,框架版本、内核实现和张量路径也可能决定能否调用。因而不能把“使用 MXFP8”直接等同于所有训练任务都更快、结果完全不变。
它的核心价值是把缩放粒度从整个张量缩小到局部块,让每组低精度数值有更适合自己的范围。理解时要分清数据格式、缩放元数据、硬件支持和模型精度评估:这四者一起决定实际效果。