QPACK:HTTP/3 如何压缩重复的请求头,还不被队头阻塞拖住?
TL;DR
QPACK 为 HTTP/3 设计动态头部词典,把重复字段压缩成索引,同时通过独立控制流和依赖管理适应 QUIC 的多流并发。
QPACK 为 HTTP/3 设计动态头部词典,把重复字段压缩成索引,同时通过独立控制流和依赖管理适应 QUIC 的多流并发。
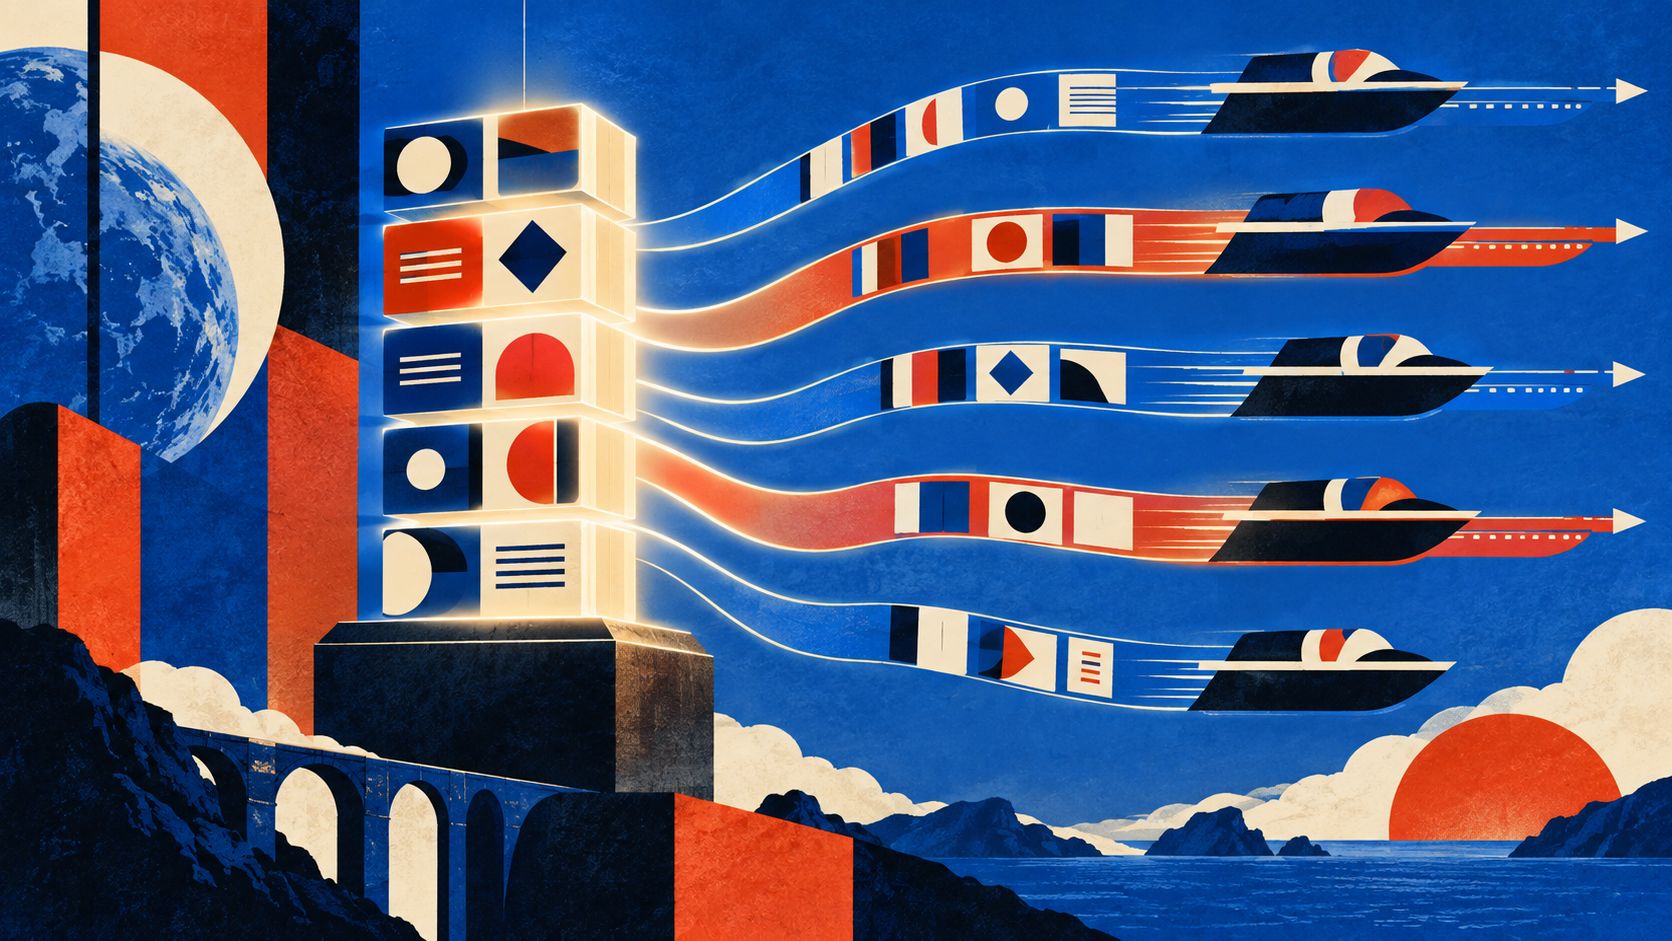
HTTP 请求头里有大量重复信息:域名、压缩编码、Cookie、缓存指令,往往一次又一次出现。QPACK 是 HTTP/3 使用的头部压缩机制,目标与 HPACK 类似,但它专门适应 QUIC 多流并发和乱序到达的特性。
可以把 QPACK 想成一个共享词典。客户端和服务器把常见的字段放进动态表,后续请求只发送较短的索引;不常见或一次性的字段则直接发送。动态表会随着通信更新,重复出现的长字符串可以被压缩成小小的引用,从而节约带宽。
问题在于,HTTP/3 的不同请求流可以独立到达。如果某个请求引用了还没到达的动态表更新,接收方就无法立刻解码。QPACK 因此把表更新放在独立的控制流上,并允许编码器声明依赖的插入位置;解码器可以选择等待,也可以利用不依赖动态表的表示继续处理。设计目标是把“压缩收益”和“队头阻塞风险”之间的关系显式化。
动态表并不是越大越好。表越大,索引越多,压缩率可能越高,但状态同步、内存占用和阻塞机会也会增加。连接两端还要限制未确认的表更新数量,防止编码器无限制地产生依赖。Cookie 等高重复但高敏感字段,也要结合隐私和跨请求关联风险谨慎使用。
QPACK 的小众之处在于,它不是单纯的字符串压缩,而是协议并发模型的一部分。理解它能帮助我们看到 HTTP/3 的一条主线:当传输层允许多个流独立前进时,上层的共享状态就必须重新设计,压缩字典也要学会与乱序和确认协作。
因此,QPACK 的调优不是一味追求最高压缩率,而是观察动态表命中率、解码阻塞、控制流确认和请求尾延迟。对于变化很快或不重复的字段,直接编码可能更稳;对于稳定重复的字段,动态表才能把额外的同步成本摊薄。协议给出的工具很多,真正的收益仍取决于流量形态。